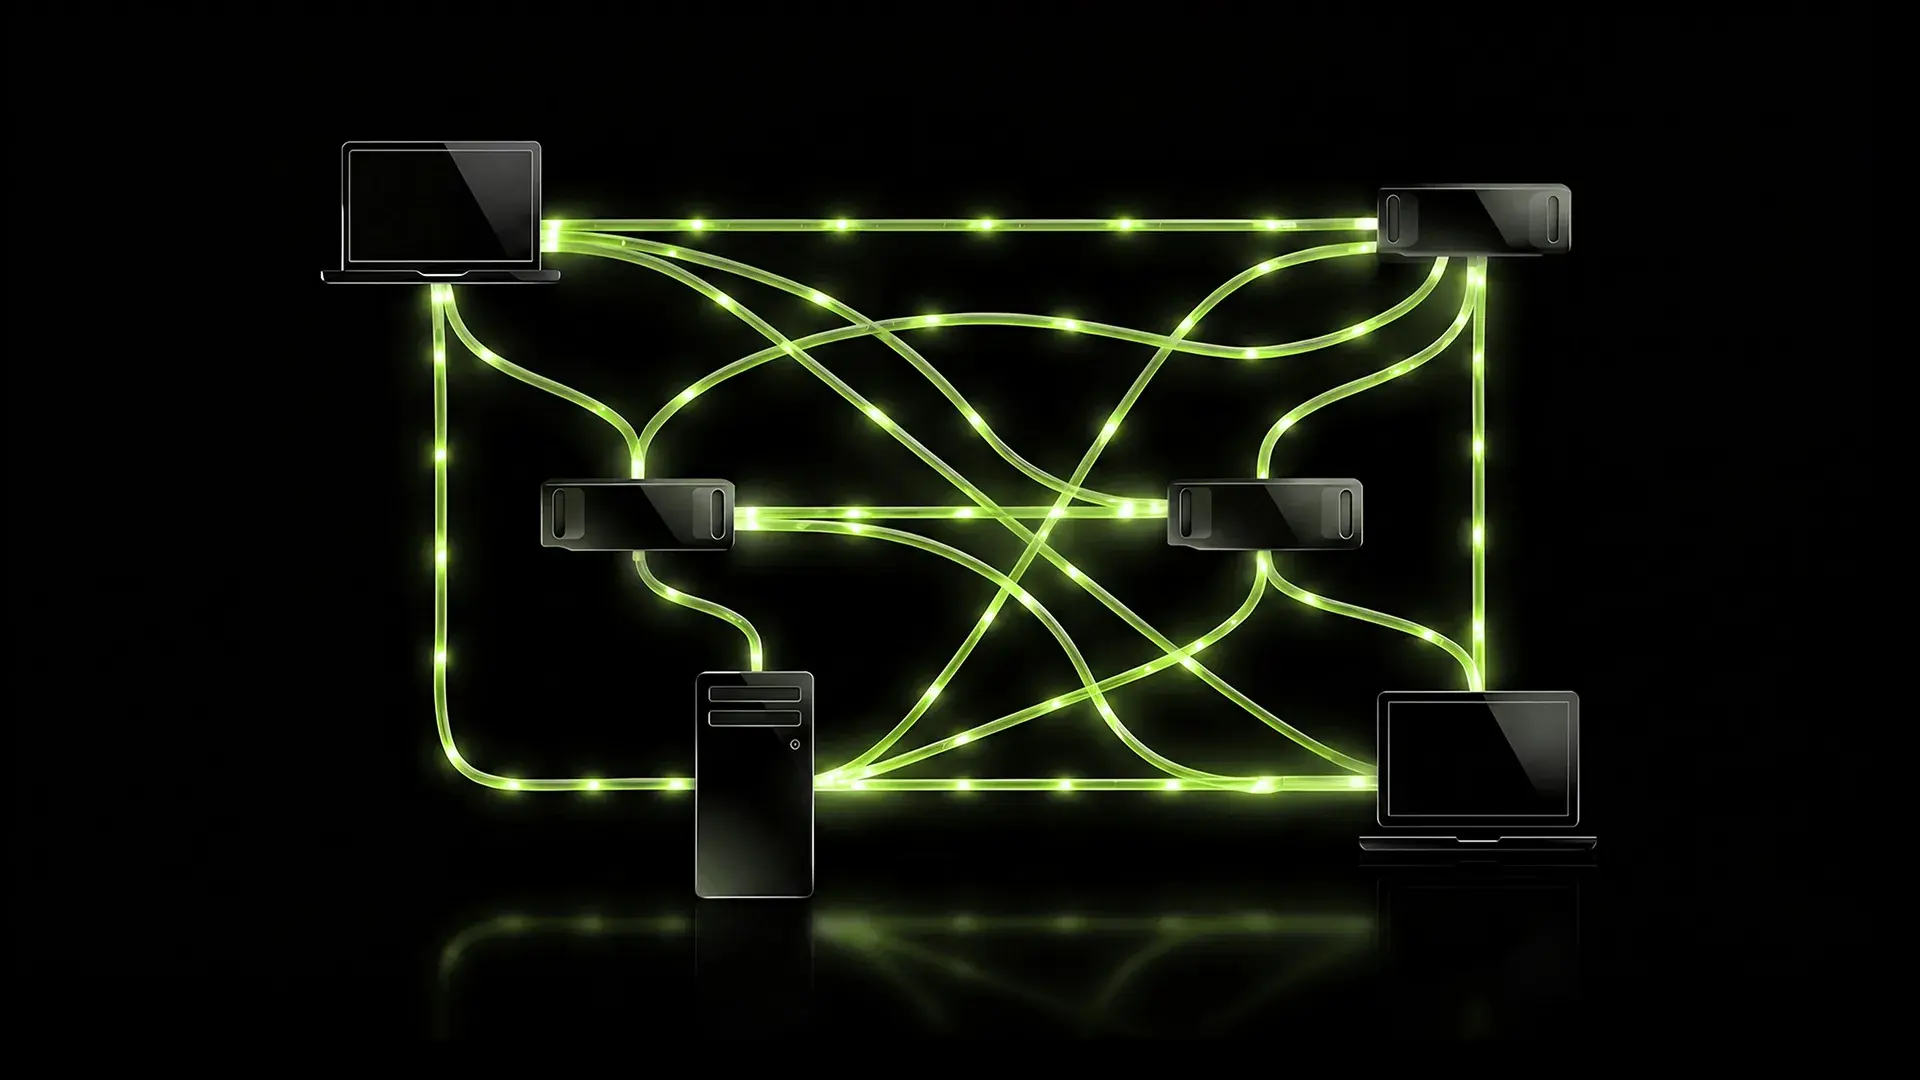
IFA 2026 izstādē NVIDIA atklāja risinājumu, kas no jauna definēs lokālo mākslīgo intelektu. To dēvē par personīgo mākslīgā intelekta maršrutētāju jeb saīsināti PAIR, un tā mērķis ir izmantot esošos mājas datorus, lai kopīgi veiktu mākslīgā intelekta uzdevumus. Tas nav fizisks maršrutētājs vai jauns secinājumu dzinējs, bet gan rīks, kas darbojas kā starpnieks starp mākslīgā intelekta lietojumprogrammām un dažādām ierīcēm lokālajā tīklā.
Ideja ir vienkārša: ja jums ir spēļu dators, darbstacija vai pat MacBook ar modernu mikroshēmu, ļoti iespējams, ka ievērojama daļa tā skaitļošanas jaudas katru dienu tiek neizmantota daudzas stundas. PAIR nosaka šīs ierīces, droši savieno tās un sadala AI aģentu ģenerētos secinājumu pieprasījumus starp tām, nodrošinot, ka darba slodzi neapgrūtina viena grafikas karte.
Kas īsti ir NVIDIA PAIR?
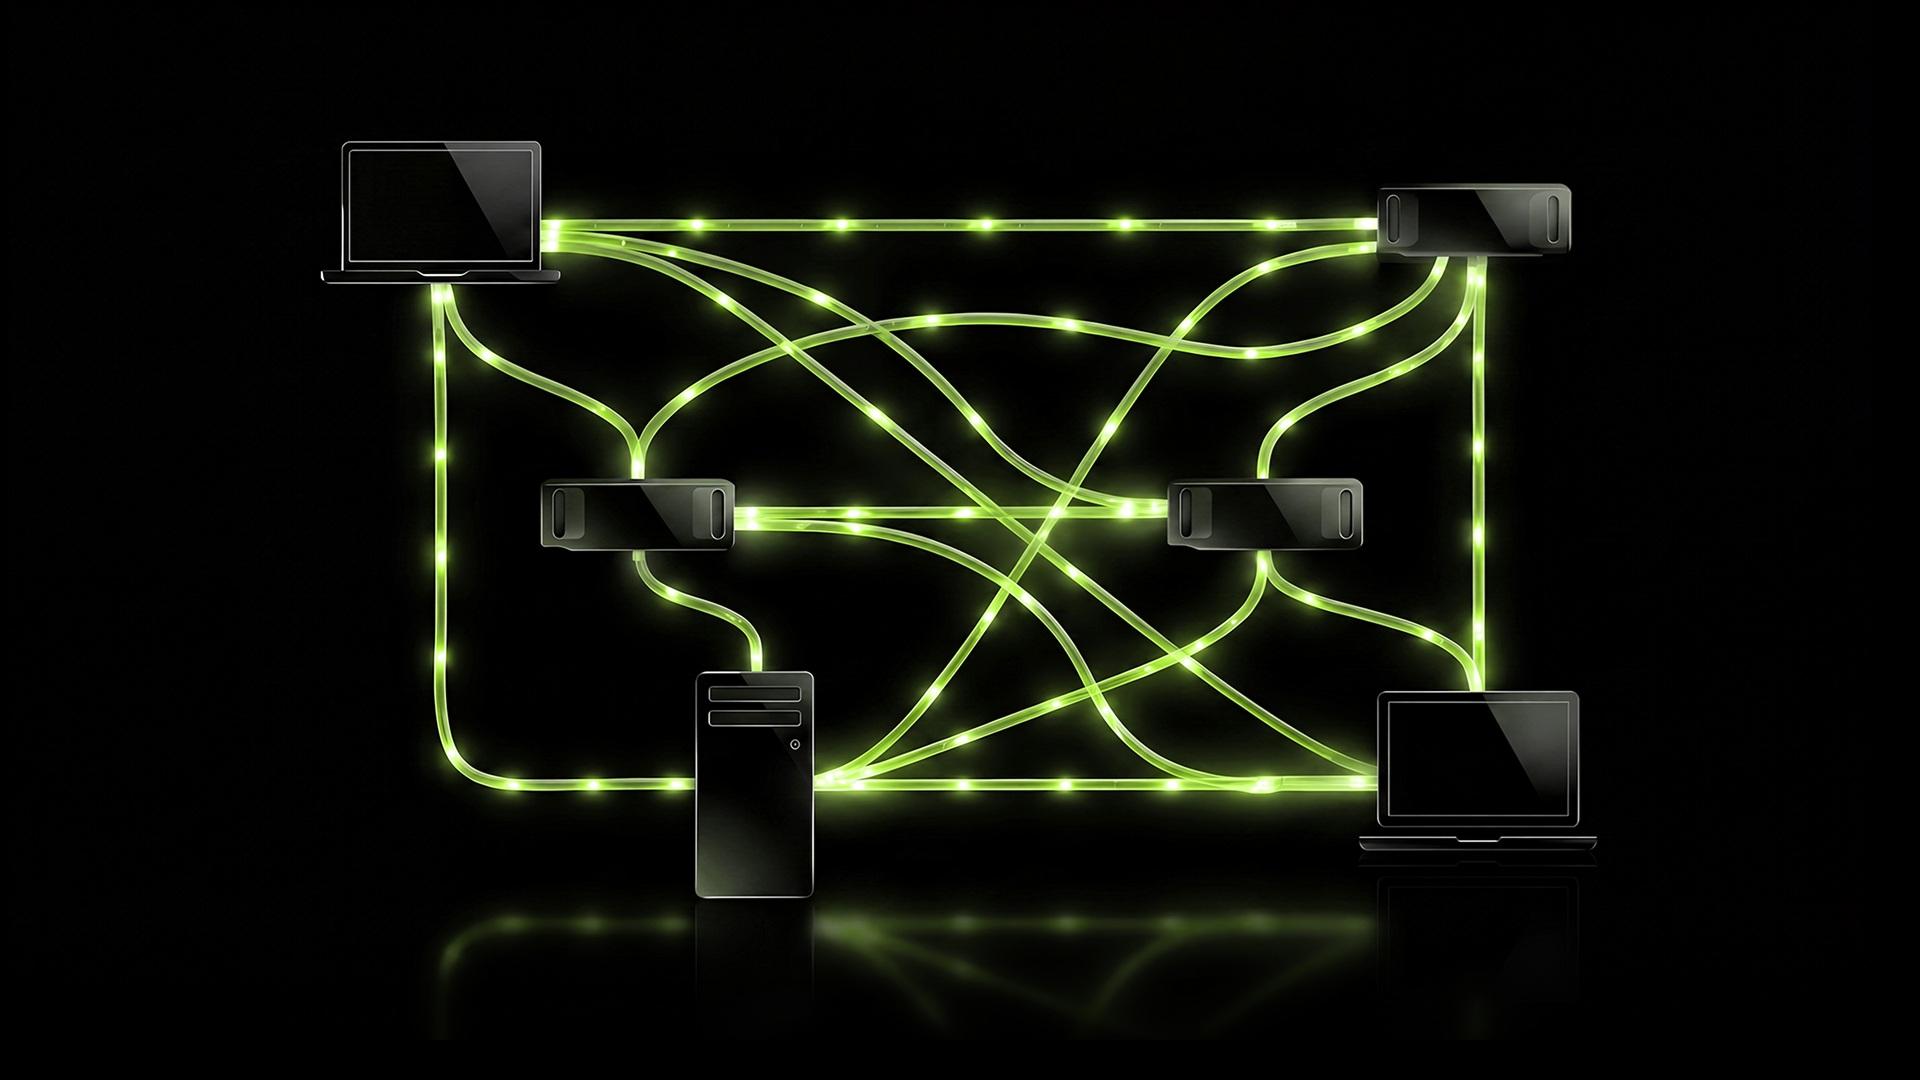
PAIR ir bezmaksas un atvērtā pirmkoda programmatūra , kas darbojas kā starpniekserveris starp mākslīgā intelekta lietojumprogrammām un katrā ierīcē instalētajiem secinājumu dzinējiem. Kad aģents vienlaikus palaiž vairākus apakšuzdevumus, PAIR izlemj, kura ierīce tīklā var apstrādāt katru no tiem, ņemot vērā, vai tajā ir ielādēts pieprasītais modelis, pašreizējo GPU slodzi un vai ierīce ir pieejama. Lietotājam pieredze ir nemanāma: viņš redz tikai vienu savienojumu, savukārt aizkulisēs datplūsma tiek sadalīta starp iesaistītajiem mezgliem.
Viena no tā galvenajām iezīmēm ir tā, ka tas neaizstāj Ollama vai LM Studio , bet gan izmanto tos. Faktiski PAIR pārņem kontroli pār portiem, ko šie dzinēji pēc noklusējuma izmanto pieprasījumu saņemšanai un pārsūtīšanai uz atbilstošāko mezglu. Tas nozīmē, ka esošās lietojumprogrammas var turpināt darboties bez izmaiņām, ievērojami samazinot ienākšanas barjeru tiem, kuriem jau ir lokāli iestatīta mākslīgā intelekta vide.
Kā darbojas uzdevumu sadalījums
Ierīču noteikšana tiek veikta, izmantojot mDNS — to pašu protokolu, ko printeris izmanto, lai parādītos tīklā . Pēc instalēšanas katra ierīce paziņo par savu pieejamību, un pārējās to automātiski nosaka. Varat arī pievienot mezglu tieši, izmantojot tā IP adresi, taču parasti galvenajā ierīcē tiek parādīts sešciparu PIN kods, kas otrai ierīcei jāievada, lai izveidotu savienojumu pārī.
Kad savienojums ir izveidots, saziņa starp mezgliem tiek šifrēta, izmantojot mTLS, kas nozīmē savstarpējus sertifikātus, kas garantē, ka datplūsma neiziet no privātā tīkla . Tas ir svarīgi tiem, kas apstrādā sensitīvu informāciju, jo aģenta instrukcijas un dati paliek lokāli, neizejot caur nevienu ārēju serveri. Tomēr projekta izstrādātāji brīdina, ka pirms tā izmantošanas koplietotos vai neuzticamos tīklos ir jāpārskata lokālā tīkla drošība , jo tas atver lokālos HTTP galapunktus un ļauj veikt atklāšanu lokālajā tīklā.
Izrādes un demonstrācijas
Miljonu dolāru jautājums ir, vai tas patiešām uzlabo veiktspēju. NVIDIA kopīgoja neoficiālu demonstrāciju ar Hermes Desktop aģentu un Ollama, kas darbināja Qwen 3.6 35B A3B modeli. Piecu apakšaģentu uzdevums, kas vienā RTX Spark klēpjdatorā aizņēma vidēji 18 minūtes, tika pabeigts 8 minūtēs un 48 sekundēs, izmantojot trīs mašīnu klasteri : klēpjdatoru, DGX Spark un RTX 5090. Šis nedaudz vairāk kā 2x uzlabojums ir izskaidrojams ar to, ka apakšuzdevumus var izpildīt paralēli vairākās GPU, nevis rindā uz vienu.
Uzņēmums uzsver, ka šis nav ne vispārējs etalons, ne lineāras mērogošanas solījums . Rezultāts lielā mērā ir atkarīgs no darba slodzes veida, izmantotā modeļa, tīkla konfigurācijas un pieejamo mezglu skaita. Ļoti secīgi uzdevumi vai tie, kuros nepieciešamais modelis ir tikai vienai mašīnai, dos mazu labumu. Turklāt PAIR neapkopo dažādu grafikas karšu atmiņu, tāpēc tas nav risinājums modeļa ielādei, kas neietilpst vienā GPU.
Saderība un prasības
PAIR beta versija ir pieejama operētājsistēmām Windows 11, Linux un macOS , un tā atbalsta x64 un arm64 arhitektūras (lai gan Windows uz ARM tiek uzskatīta par eksperimentālu). Aparatūras prasības ietver GeForce RTX 20 sērijas vai jaunākas grafikas kartes, uz Turing bāzes veidotu RTX PRO vai jaunāku versiju, DGX Spark vai Apple M4 vai jaunākas mikroshēmas. Nepieciešami arī vismaz 8 GB RAM un 20 GB diska vietas, un interneta savienojums nav nepieciešams darbībai, tikai veidņu lejupielādei.
Interesanti, ka PAIR neaprobežojas tikai ar NVIDIA produktiem ; tajā var piedalīties jebkurš dators, kas var darbināt Ollama vai LM Studio, tostarp sistēmas ar Apple Silicon. Faktiski tā ir veiksmīgi pārbaudīta tīklos ar līdz pat 18 GPU. Mezglu elastība pievienoties un iziet, kad tie vēlas — piemēram, ja klēpjdators pāriet miega režīmā vai dators sāk spēlēt spēli — ir vēl viena no tā raksturīgajām iezīmēm, jo plānotājs pielāgo sadalījumu reāllaikā.
RTX Spark un citas jaunas funkcijas
PAIR parādās laikā, kad NVIDIA arī pabeidz pirmo datoru ar RTX Spark izlaišanu, kas paredzēta oktobrī. Šīs mašīnas apvieno Blackwell GPU ar 20 kodolu Grace centrālo procesoru un līdz pat 128 GB vienotās atmiņas, un ir paredzētas mākslīgā intelekta aģentu lokālai darbināšanai. IFA izstādē savus piedāvājumus demonstrēja Lenovo (Yoga Pro 9n un Yoga 9n) un Acer (kompakta galddatora koncepcija), un paredzams, ka savus modeļus atklās arī Dell, HP, ASUS, MSI un Microsoft.
Līdztekus PAIR, NVIDIA ir paziņojusi par vienkāršojumiem arī citiem aģentu projektiem. Perplexity Portable Computer atbalstīs RTX GPU ar vismaz 24 GB VRAM gan Windows, gan Linux operētājsistēmās, ļaujot lietotājiem palaist pilnīgas darbplūsmas, netērējot kredītpunktus un ar iepriekšēju atļauju sūtīt datus uz mākoni. Hermes Agent ietvers viena klikšķa iestatīšanu, kas automātiski nosaka GPU, un arī OpenClaw būs līdzīga opcija operētājsistēmā Windows.
Runājot par veiktspēju, llama.cpp optimizācijas ļauj palielināt caurlaidspēju līdz pat 1,9 reizēm GeForce RTX 5090 kartē , savukārt vLLM uzlabo caurlaidspēju 1,2 reizes Blackwell RTX PRO 6000 kartē un līdz pat 1,4 reizēm divu DGX Spark karšu klasteros. Šie uzlabojumi jau ir pieejami, izmantojot LM Studio, Ollama un pašas programmas.
Tas viss norāda uz skaidru tendenci: lielākā daļa mākslīgā intelekta darba tiek pārvietota ārpus mākoņa un tiek izmantota aparatūra, kas mums jau ir mājās. PAIR ir vēl viens šīs puzles gabaliņš, un, lai gan tas ir beta versijā, to ir vērts izmēģināt, ja jums ir vairāk nekā viens jaudīgs dators. Galīgajai versijai vēl nav izlaišanas datuma, taču kopiena to jau var lejupielādēt un sniegt uzlabojumus, izmantojot GitHub.
Indekss